Anthropic - Akıcı ve Etkili Yapay Zekâ Kullanımı Eğitimi (Kısım 2)
Geçtiğimiz hafta ilk kısmını aktardığım Anthropic AI Fluency eğitiminin ikinci kısmından notlarımı paylaşacağım.
Herkese iyi pazarlar ve iyi bayramlar diliyorum.
Bayram tatilinden ötürü bu haftaki yazımı pazartesi günü mü paylaşsam diye düşünüyordum ama rutini bozmamak adına aynı gün ve saatte devam etmeye karar verdim. Bugünkü yazımda geçtiğimiz hafta ilk kısmını aktardığım Anthropic AI Fluency eğitiminin ikinci kısmından notlarımı paylaşacağım.
Hazırsanız başlayalım.

4D Formülü ile İlgili Biraz Daha Detay: Yapay Zekâ ile İş Birliği Sanatı
Süreci Stratejik Olarak Bölmek: Devretme (Delegation) ve Tanımlama (Description)
İlk bölümde kısaca değindiğimiz 4D formülünü bu kısımda detaylandırıyorum. Hangi etkileşim modelini kullanırsak kullanalım (ister otomasyon, ister düşünce ortaklığı, ister özerk temsilcilik olsun), bu dört temel yetkinlik her koşulda geçerli.
İlk başlık Devretme (Delegation).
Eğitimin bu kısmını izlerken daha iyi anladım ki, bu aşama sadece "şu işi benim yerime yap" demekten ziyade; büyük resmi görmek ve iş bölümünü stratejik olarak kurgulamakla ilgili. Örneğin, kapsamlı bir araştırma projesinde uzun belgeleri okuma ve verileri özetleme işini yapay zekâ asistanınıza rahatlıkla devredebilirsiniz. Ancak kritik bir analizi yapma ve nihai sonuçları çıkarma işini mutlaka kendinize saklamalısınız. Etkili bir devretme işlemi için hedefinizi çok iyi anlamalı, yapay zekânın neyi iyi yapıp neyi yapamayacağını bilmeli ve görevleri bilinçli bir şekilde paylaştırmalısınız.
---
İkinci yetkinliğimiz ise Tanımlama (Description).
Anthropic burada meselenin sadece "iyi bir prompt yazmak" olmadığının, aksine bağlam açısından zengin bir iletişim kurmak olduğunun altını çiziyor. Sadece "Bana bir logo yap" demek yerine; şirketinizin değerlerini, hedef kitlesini, tercih ettiğiniz renkleri ve stili anlatmak arasındaki büyük farkı düşünün. Ya da yapay zekâyı bir özel öğretmen gibi kullanırken, "Bana doğrudan cevabı verme, konuyu anlamam için adımları tek tek benimle birlikte çöz" diyerek süreci çok daha verimli yönlendirebilirsiniz. Beklentilerinizi, formatı, ihtiyaç duyulan bağlamı ve etkileşimin tonunu net bir şekilde aktarmak, başarılı bir ortaklığın kilidini açıyor.
---
Döngüyü Tamamlamak: Ayırt Etme (Discernment) ve Özen Gösterme ve Sorumlu Olma (Diligence)
Sürecin üçüncü adımı olan Ayırt Etme (Discernment)
Yapay zekânın bize sunduklarını kendi uzmanlık filtremizden geçirmemizi ifade ediyor. Diyelim ki bir pazarlama stratejisi istediniz; gelen yanıtın gerçeklere uygun olup olmadığını, mantıklı bir temele dayanıp dayanmadığını ve marka değerlerinizle örtüşüp örtüşmediğini değerlendirmek tamamen sizin işiniz. Eğitimin de vurguladığı gibi, aslında yapay zekâ ile olan etkileşimlerimizin çoğu, bu "tanımlama" ve "ayırt etme" arasında gidip gelen küçük döngülerden oluşuyor: İhtiyacımızı tanımlıyor, gelen sonucu değerlendiriyor, talebimizi rafine ediyor ve tekrar deniyoruz.
---
Son ve belki de en kritik aşama ise Özen Gösterme ve Sorumlu Olma (Diligence).
İşin içine etik, güvenlik ve şeffaflık kavramları tam da burada giriyor. İşe alım süreçlerinde veya önemli kararlarda yapay zekâ kullanıyorsak, olası ön yargıları nasıl kontrol edeceğiz? Hassas verilerimizi nasıl koruyacağız? Anthropic'in burada sorduğu çok vurucu bir soru var: "Yapay zekâ desteğiyle yaptığınız işin sorumluluğunu almaya ve ortaya çıkan nihai ürünün arkasında durmaya istekli misiniz?"
Özetle; belirli bir araca veya yarın unutulacak komutlara bel bağlamak yerine; strateji, iletişim, muhakeme ve sorumluluk üzerine kurulu bu 4D becerilerine yatırım yapmalıyız. Teknoloji ne kadar hızlı değişirse değişsin, bu temel yetkinlikler bizim sistemle birlikte büyümemizi sağlayacak.

Üretken Yapay Zekânın Temelleri: Analizden Yaratıma Geçiş
Geleneksel Sistemlerden Büyük Dil Modellerine
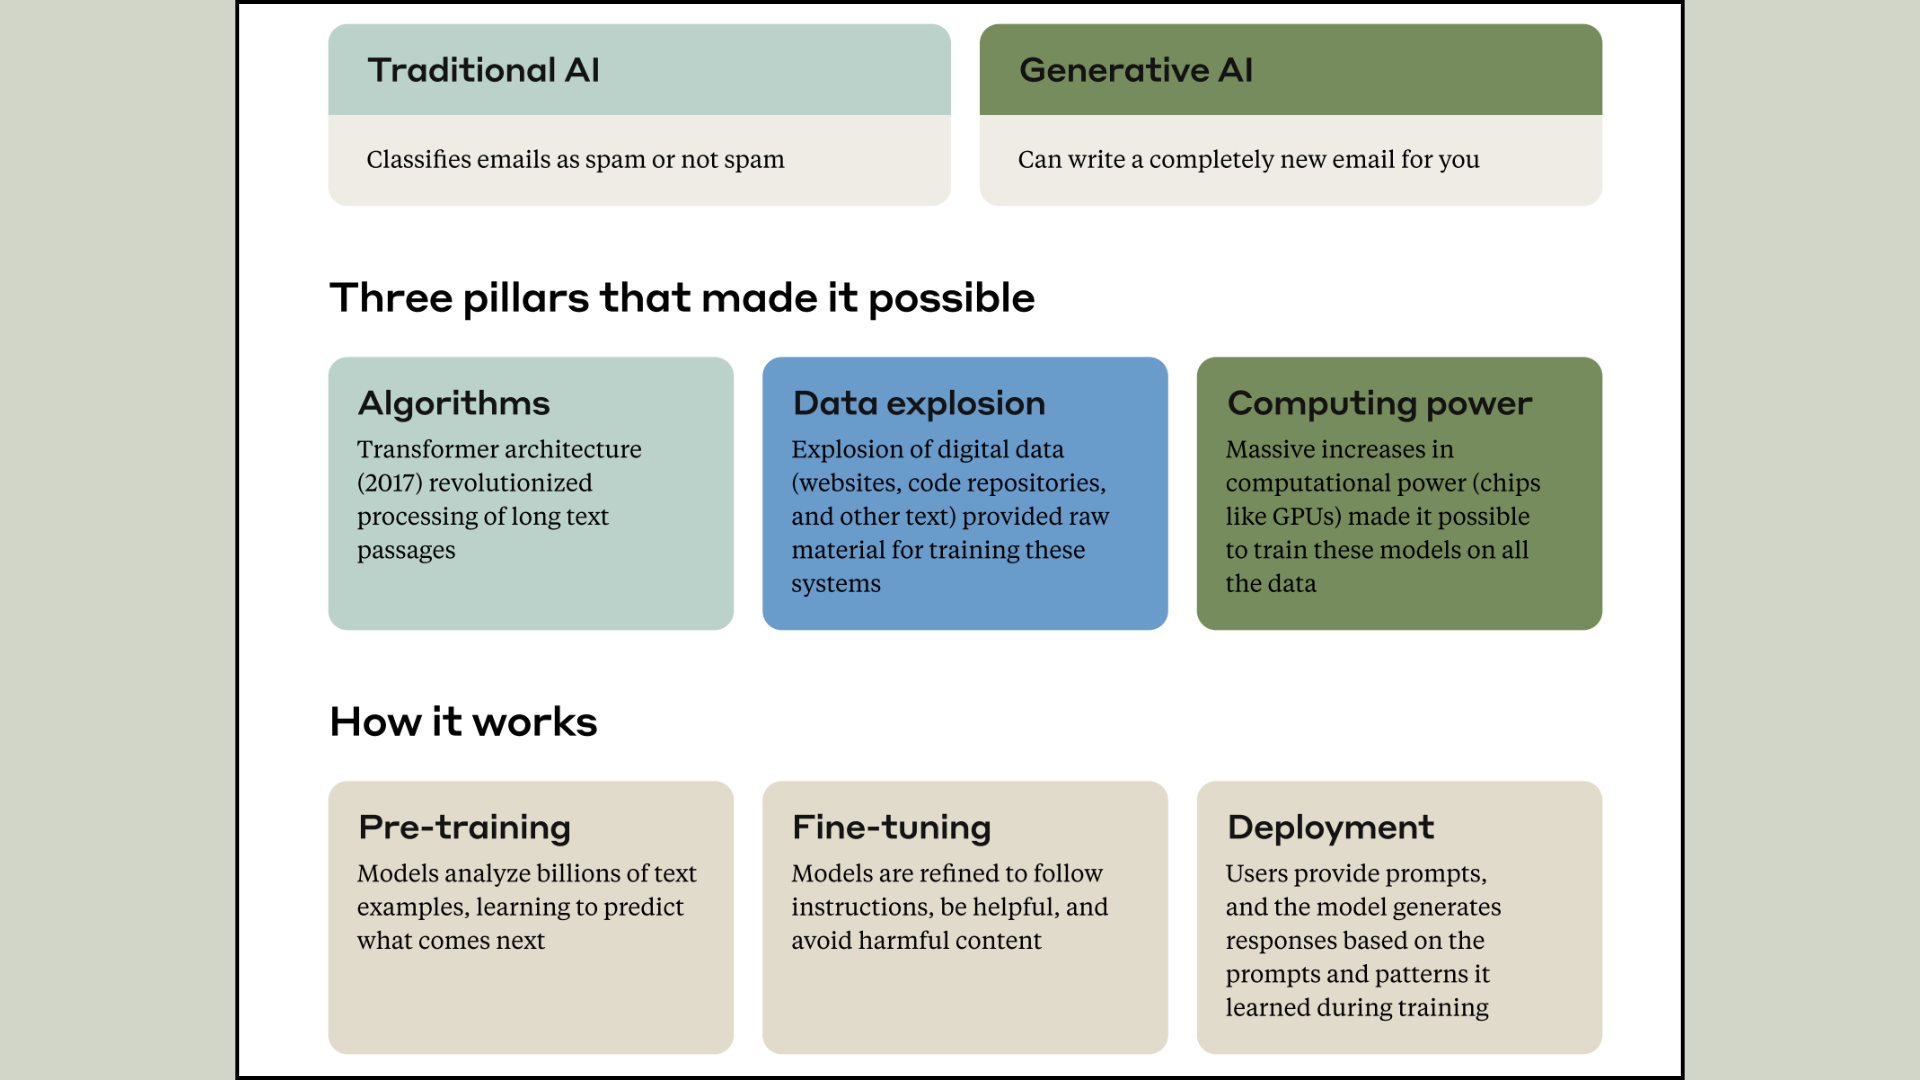
Anthropic eğitiminin bu teknik bölümünde, üretken (generative) yapay zekânın temel çalışma prensiplerini ve bu sistemleri mümkün kılan teknolojik altyapı inceleniyor. Geleneksel yapay zekâ sistemleri verileri yalnızca analiz edip sınıflandırma görevini üstlenirken (örneğin bir e-postayı spam olarak ayırmak gibi), üretken yapay zekâ daha önce var olmayan yepyeni bir içerik (örneğin sıfırdan bir e-posta) oluşturabiliyor. Anthropic bu durumu yapay zekâ yeteneklerinde temel bir paradigma değişimi olarak tanımlıyor.
Bu değişimin merkezinde Claude gibi Büyük Dil Modelleri (LLM) yer alıyor. Eğitime göre bu sistemlere "dil modeli" denmesinin sebebi insan dilini tahmin edip üretecek şekilde eğitilmeleri; "büyük" denmesinin sebebi ise beynimizdeki sinaptik bağlantılara benzer şekilde, bilginin nasıl işleneceğini belirleyen milyarlarca matematiksel parametre içermeleri.
Bu Devrimi Mümkün Kılan Üç Teknolojik Sıçrama
Günümüzdeki üretken yapay zekâ sistemleri tek bir keşfin değil, üç kritik gelişmenin doğru zamanda bir araya gelmesinin bir sonucu:
-
Transformer Mimarisi (2017): Uzun metinlerdeki kelimeler arası ilişkileri koruyarak yapay zekânın dilin bağlamını kavramasını sağlayan temel algoritmik sıçrama.
-
Veri Patlaması: İnternetteki web siteleri ve kod havuzları, modellerin insan dilini ve bilgisini öğrenmesi için gereken devasa hammaddeyi sağlamış.
-
Hesaplama Gücü: GPU ve TPU gibi özel donanımların gelişmesi, bu karmaşık modellerin o devasa veriler üzerinde eğitilmesini mümkün kılmış.
Bu üç faktörün birleşimi, "Ölçeklenme Yasaları" (Scaling Laws) adı verilen çok önemli bir keşfe yol açmış. Ampirik bulgulara göre, modeller büyüdükçe ve daha fazla veri/işlem gücüyle eğitildikçe performansları öngörülebilir bir şekilde artmaktadır. Araştırmacıların asıl dikkat çektiği nokta ise, modeller büyüdükçe açıkça programlanmamış "adım adım mantık yürütme" veya "yeni görevlere adapte olma" gibi yepyeni yeteneklerin kendiliğinden ortaya çıkması.
Sistemin İşleyişi: Ön Eğitim, İnce Ayar ve Bağlam Penceresi
Yapay zekâ ile akıcı bir etkileşim kurabilmek için bu modellerin nasıl yapılandırıldığını bilmek gerekiyor. Anthropic eğitiminde bu süreç iki temel aşamayla açıklanıyor:
-
Ön Eğitim (Pre-training): Modelin milyarlarca metni inceleyerek kelimeler ve kavramlar arasındaki istatistiksel ilişkilerin karmaşık bir haritasını çıkardığı aşama. Sistem burada bir sonraki kelimeyi tahmin etmeyi öğrenir.
-
İnce Ayar (Fine-tuning): Modelin insan geri bildirimleri kullanılarak talimatları takip etmeyi ve zararlı içerik üretmekten kaçınmayı öğrendiği aşama. Anthropic modellerinde bu süreç, yapay zekânın tamamen "yardımsever, dürüst ve zararsız" (helpful, honest, harmless) bir davranış sergilemesi için ödül/ceza mekanizmalarıyla şekillendirilir.
Sistemi kullanırken teknik olarak bilmemiz gereken en önemli sınır ise "Bağlam Penceresi" (Context Window). Biz bir komut (prompt) yazdığımızda, model hazır bir veritabanından cevap çekmez; o anki verilere dayanarak istatistiksel olarak yeni bir metin üretir. Ancak bunu yaparken sadece sistemin "çalışma belleği" olan bağlam penceresindeki (promptlar, yanıtlar ve paylaşılan dokümanlar) bilgileri kullanabilir. Web araması gibi özel araçlar kullanılmadığı sürece bu mevcut pencerenin dışındaki bilgilere erişemez.
Özetle, modern üretken yapay zekâyı bu kadar güçlü kılan üç karakteristik özellik bulunuyor: Devasa bilgiyi işleme kapasitesi, komutlarınız üzerinden ek eğitime ihtiyaç duymadan yeni görevlere uyum sağlama (in-context learning) yeteneği ve model büyüdükçe ortaya çıkan o yeni yetenekler.
Anthropic AI Fluency eğitiminin 2.kısmında yapay zekânın gelişimini teknik olarak biraz daha yakından inceledik. Önümüzdeki hafta paylaşacağım 3.kısımda 4D modelinin her bir başlığına çok daha kapsamlı bir şekilde göz atacağız. Eğitimin kendisini izlemek isterseniz de mutlaka tavsiye ederim.
Yazıyı okuduğunuz için teşekkür ederim.
Şimdiden bayram sonrası için iyi bir çalışma haftası diliyorum.
Enis Erdem Yurdatapan